autoresearch là gì: Karpathy để AI agent tự nghiên cứu qua đêm
autoresearch là gì: repo của Andrej Karpathy cho AI agent tự sửa code huấn luyện, chạy thử 5 phút, giữ cái tốt, bỏ cái kém, lặp suốt đêm.
Thử hình dung thế này. Chị trưởng nhóm dữ liệu có một mô hình dự báo doanh số và cả trăm ý tưởng muốn thử: đổi tham số này, bỏ cột kia, thêm bước làm sạch nọ. Mỗi lần thử mất vài phút, nhưng ngồi canh từng lần thì hết cả tuần. Giá mà có ai thử giúp suốt đêm, sáng ra chỉ việc đọc bảng kết quả.
autoresearch là gì? Đây là repo mã nguồn mở Andrej Karpathy công khai sáng 07/03/2026 theo giờ Việt Nam, để một AI agent tự làm đúng việc đó với code huấn luyện mô hình ngôn ngữ: tự sửa, chạy thử, xem tốt hơn hay kém đi, rồi quyết định giữ hay bỏ. Người dùng đi ngủ, sáng dậy có một bảng nhật ký thí nghiệm.
Đọc nhanh trong 30 giây
- autoresearch là repo
karpathy/autoresearchcủa Andrej Karpathy, công khai ngày 07/03/2026, giấy phép MIT.- Agent tự sửa
train.py, huấn luyện đúng 5 phút, đoval_bpb; tốt hơn thì giữ commit, không thì quay lại. Theo README, mỗi giờ 12 lần thử, một đêm chừng 100 lần.- Cần một GPU NVIDIA, Python 3.10 trở lên và uv; cài bằng
uv syncrồiuv run prepare.py.- Hợp nhất với người muốn học cách giao việc dài hơi cho agent. Ít doanh nghiệp cần cài ngay.
autoresearch là gì, dùng vào việc gì?
autoresearch là một bộ khung tối giản của Karpathy, trong đó AI agent đóng vai nhà nghiên cứu và con người đóng vai người viết luật. Phần huấn luyện là bản rút gọn chạy trên một GPU của nanochat, dự án dựng ChatGPT mini mà Karpathy ra mắt trước đó.
Theo README, cả repo chỉ có ba file quan trọng:
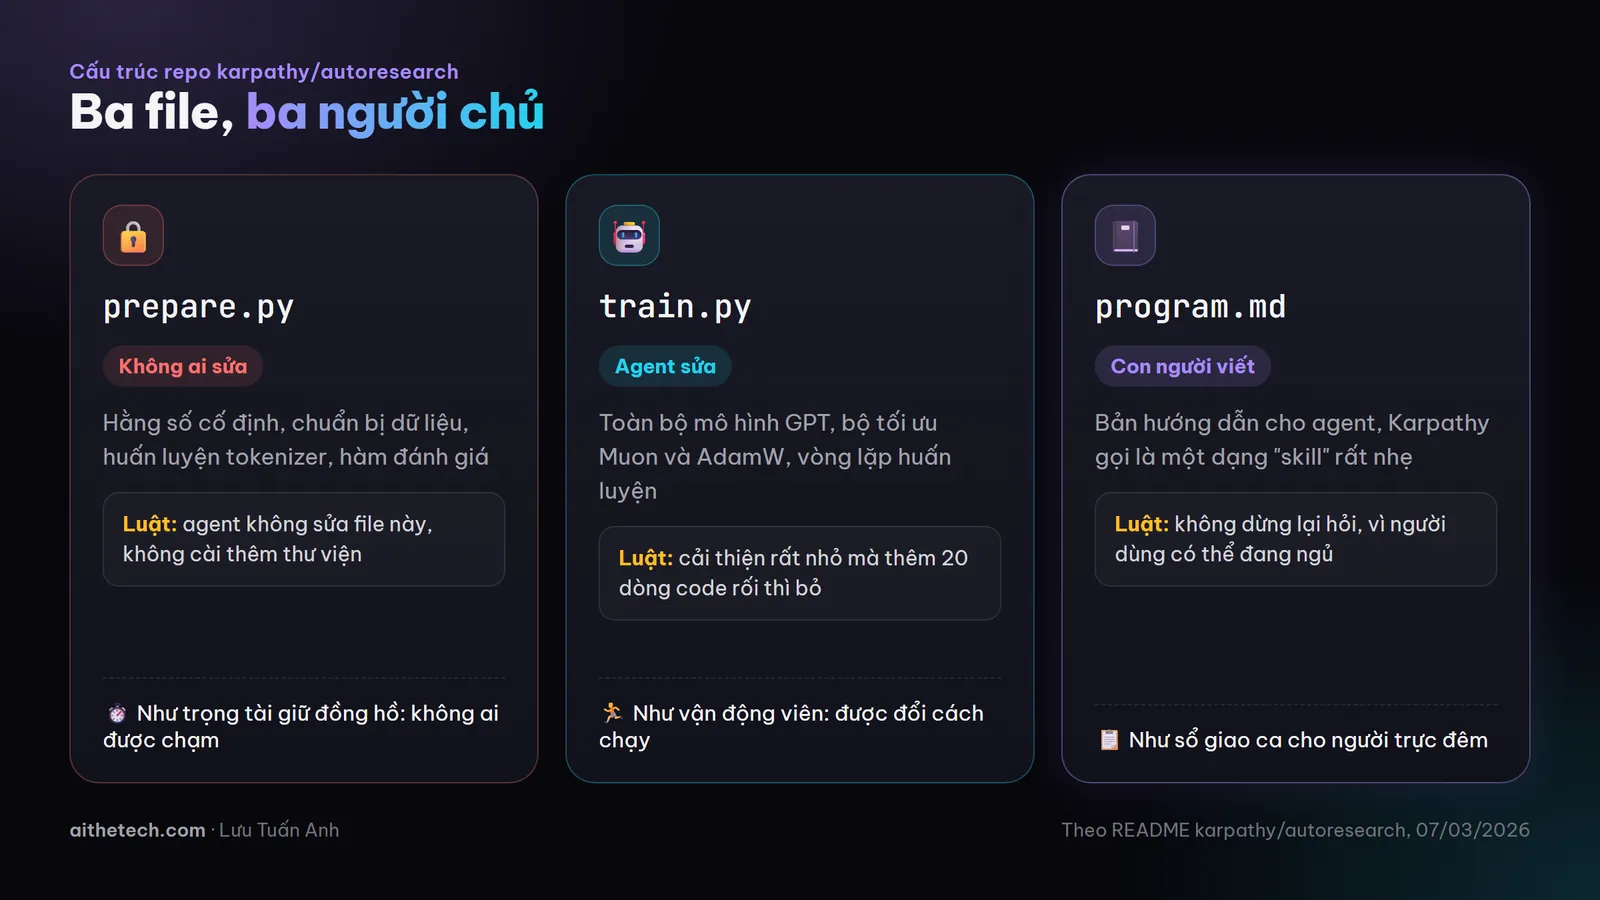
Mỗi file một chủ: thước đo khóa cứng, agent chỉ sửa một file, con người viết luật.
| File | Ai sửa | Vai trò |
|---|---|---|
prepare.py |
Không ai sửa | Hằng số cố định, chuẩn bị dữ liệu, huấn luyện tokenizer, hàm đánh giá |
train.py |
Agent | Toàn bộ mô hình GPT, bộ tối ưu Muon và AdamW, vòng lặp huấn luyện |
program.md |
Con người | Bản hướng dẫn cho agent |
Điểm đáng chú ý nằm ở file thứ ba. Karpathy viết rằng người làm nghiên cứu không còn sửa file Python như trước, mà viết program.md để "lập trình" cho cả một tổ nghiên cứu gồm các agent. Ông gọi file này là một dạng "skill" rất nhẹ. Ví von cho dễ hiểu: program.md giống sổ giao ca cho người trực đêm. Trưởng ca ghi rõ được làm gì, cấm đụng vào đâu, gặp sự cố thì xử lý ra sao, rồi về ngủ yên tâm.
autoresearch chạy suốt đêm như thế nào?
Mỗi lần thử, mô hình được huấn luyện đúng 5 phút theo đồng hồ thật, không tính thời gian khởi động. Thước đo là val_bpb, số bit trên mỗi byte ở tập kiểm tra, càng thấp càng tốt. Thời gian cố định nên lần nào cũng so được với lần nào.
Giống một cuộc thi chạy có trọng tài giữ đồng hồ. Vận động viên được đổi giày, đổi cách thở, đổi nhịp chân, nhưng không ai được chạm vào đồng hồ hay dời vạch đích. Agent trong autoresearch cũng vậy: được đổi cách làm, không được đổi thước đo.
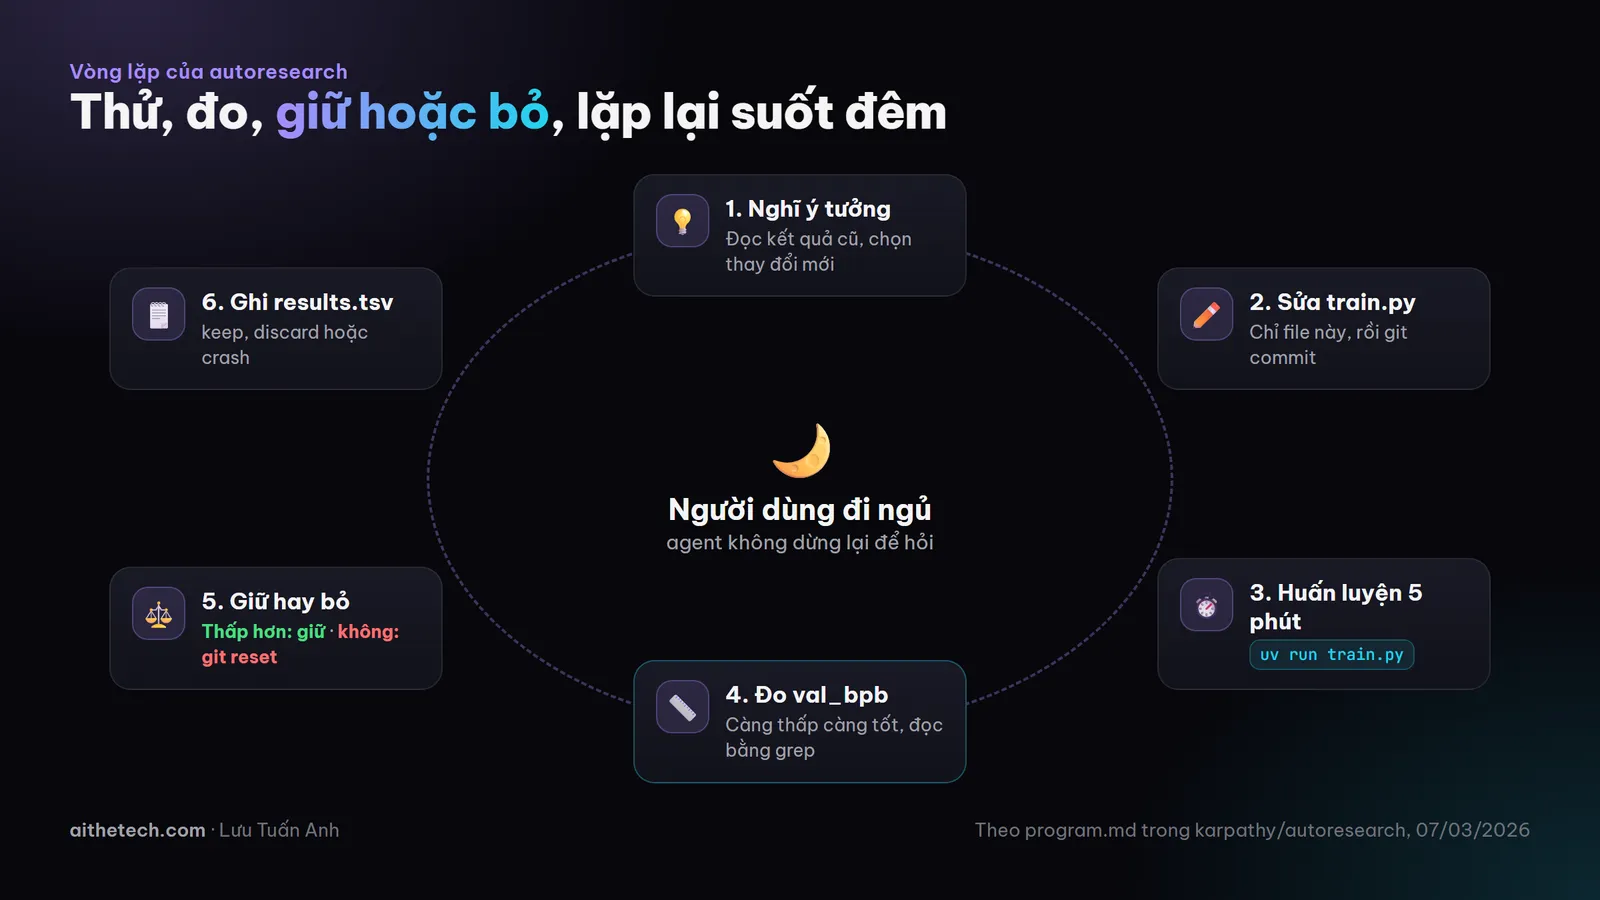
Vòng lặp thử, đo, giữ hoặc bỏ mà agent lặp lại suốt đêm.
File program.md mặc định đọc như một bản SOP cho nhân viên mới:
- Agent cùng người dùng đặt tên cho đợt chạy, ví dụ theo ngày, rồi tạo nhánh git
autoresearch/<tên>. - Agent đọc README,
prepare.py,train.pyđể nắm bối cảnh, kiểm tra dữ liệu đã có chưa. - Lần chạy đầu luôn là chạy nguyên bản để lấy mốc so sánh.
- Từ đó agent tự nghĩ ý tưởng, sửa
train.py, commit, chạyuv run train.py > run.log 2>&1. - Đọc kết quả bằng
grep. Nếuval_bpbthấp hơn thì giữ commit, nếu bằng hoặc kém hơn thìgit resetvề chỗ cũ. - Ghi mỗi lần thử vào
results.tsvvới trạng tháikeep,discardhoặccrash.
Ba luật đáng học. Một, agent không được sửa prepare.py, không cài thêm thư viện, không đụng hàm đánh giá. Hai, đơn giản hơn thì tốt hơn: cải thiện rất nhỏ mà thêm 20 dòng code rối thì bỏ. Ba, không dừng lại hỏi có nên tiếp tục không, vì người dùng có thể đang ngủ.
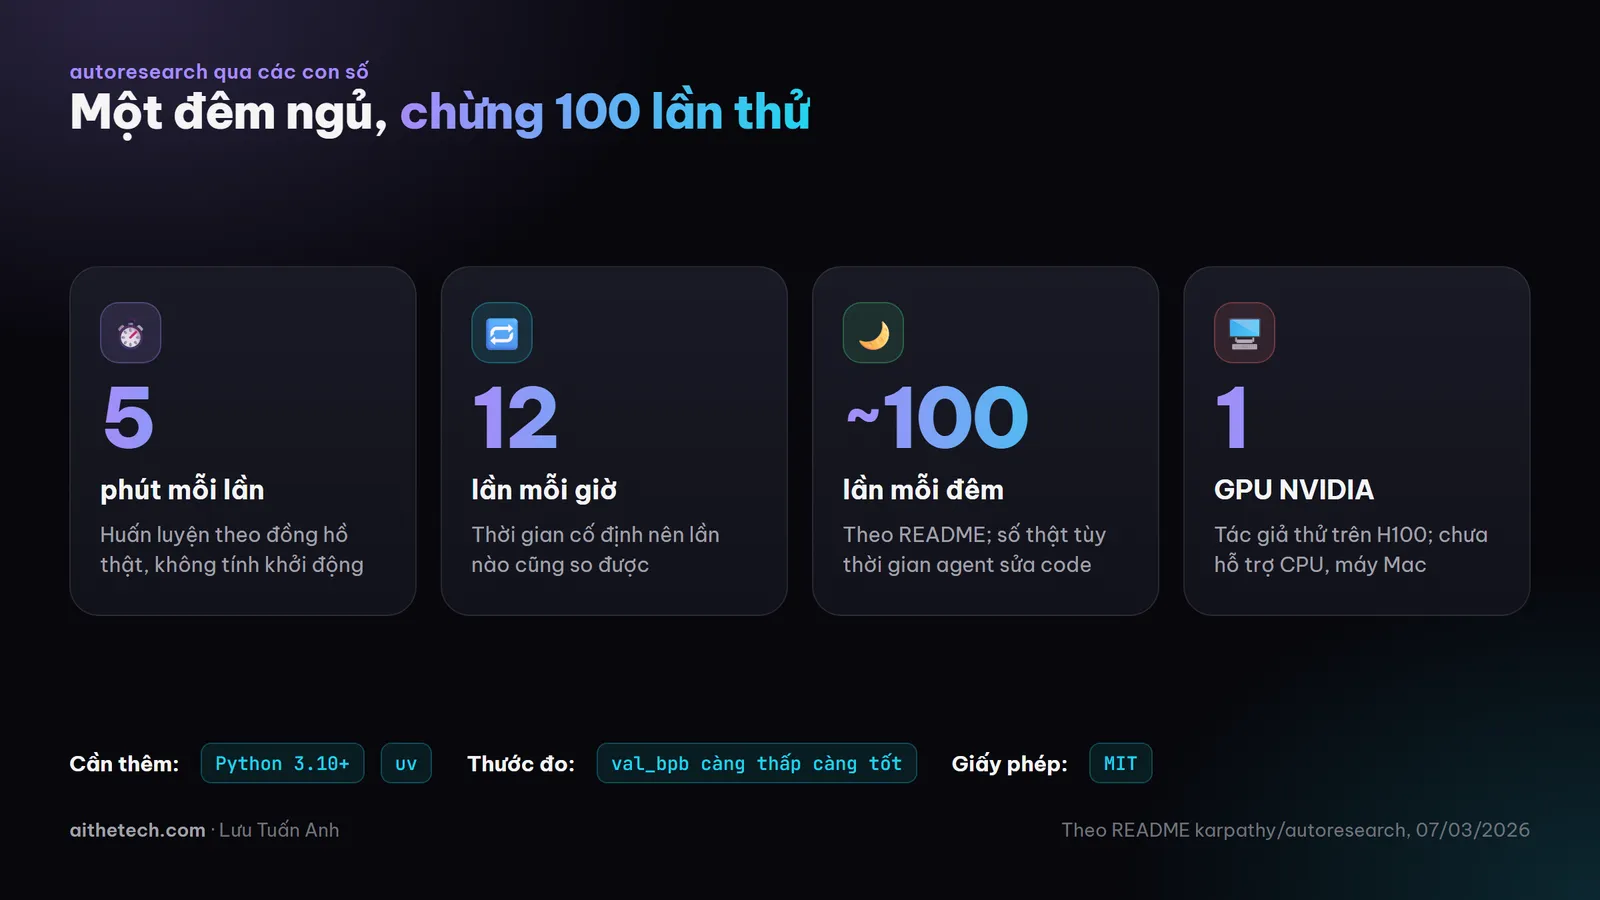
Các con số theo README. Số lần thật mỗi đêm còn tùy thời gian agent đọc log và sửa code.
Cài autoresearch và chạy thử
Yêu cầu theo README: một GPU NVIDIA (tác giả thử trên H100), Python 3.10 trở lên và trình quản lý dự án uv. Karpathy nói rõ hiện chỉ hỗ trợ một GPU NVIDIA, chưa hỗ trợ CPU hay máy Mac.
- Cài uv nếu máy chưa có:
curl -LsSf https://astral.sh/uv/install.sh | sh
- Cài thư viện, tải dữ liệu, huấn luyện tokenizer (làm một lần):
uv sync
uv run prepare.py
- Chạy tay một lần huấn luyện để chắc máy chạy được:
uv run train.py
- Mở Claude Code, Codex hoặc agent lập trình anh chị đang dùng ngay trong thư mục repo. README gợi ý tắt hết các bước xin quyền rồi gõ:
Hi have a look at program.md and let's kick off a new experiment! let's do the setup first.
Agent làm phần chuẩn bị cùng anh chị, sau đó tự chạy vòng lặp.
Mẹo
Không có GPU vẫn học được nhiều từ repo này. Mở
program.mdra đọc như một mẫu giao việc cho agent: mục tiêu đo được, vùng được sửa và vùng cấm, giới hạn thời gian mỗi lần thử, cách ghi nhật ký, luật xử lý khi lỗi. Đây là khung tốt để viết hướng dẫn cho agent làm việc dài trong công ty.
Áp khuôn autoresearch cho bài toán của công ty
Quay lại mô hình dự báo doanh số ở đầu bài. Giả sử đội dữ liệu có một script dự báo và một bộ số liệu kiểm tra cố định. Anh chị có thể viết một file hướng dẫn theo đúng khuôn của autoresearch:
Mục tiêu: giảm sai số dự báo trên tập kiểm tra tháng trước.
Chỉ được sửa forecast.py. Không sửa dữ liệu, không sửa hàm tính sai số.
Mỗi lần thử: commit, chạy, ghi kết quả vào results.tsv.
Tốt hơn thì giữ, không tốt hơn thì quay lại commit trước.
Điều kiện để khuôn này chạy được: thước đo rõ, chạy nhanh, và agent không có cách nào "ăn gian" bằng cách sửa thước đo.
Lưu ý
- Phần cứng. Cần GPU NVIDIA. Kết quả trên máy khác nhau không so được với nhau, vì cùng 5 phút nhưng sức máy khác.
- Quyền của agent. Tắt xin quyền nghĩa là agent tự chạy lệnh trên máy không cần hỏi. Chỉ làm trên máy riêng cho thí nghiệm, không làm trên máy chứa dữ liệu công ty.
- Chi phí. Mỗi lần thử là một lượt agent đọc log, nghĩ, sửa code. Chạy suốt đêm thì tốn lượt dùng của gói AI. README không ghi chi phí.
- Mức hỗ trợ. Karpathy nói code chỉ là bản minh họa và ông chưa chắc sẽ hỗ trợ lâu dài.
Nhận xét của chuyên gia
Tôi không xem autoresearch là công cụ để doanh nghiệp Việt cài ngay. Rất ít công ty có GPU H100 ngồi chờ, và huấn luyện mô hình ngôn ngữ không phải việc của đa số. Giá trị thật nằm ở cách tổ chức công việc cho agent. Khi tư vấn triển khai agent, câu hỏi tôi gặp nhiều nhất là làm sao biết agent tự làm mà vẫn đúng. autoresearch trả lời gọn: một con số để tối ưu, cách đo bị khóa, vùng sửa có giới hạn, nhật ký mọi lần thử, và mọi thay đổi quay lui được bằng git.
Hợp với ai: đội kỹ thuật, đội dữ liệu có bài toán đo được bằng một con số, như chỉnh prompt trích xuất hóa đơn hay phân loại email trên tập dữ liệu cũ.
Chưa hợp với ai: việc mà kết quả cần người đánh giá cảm tính; việc chạm tới hệ thống thật như gửi email khách hàng, sửa dữ liệu kế toán. Rủi ro lớn nhất là agent tối ưu đúng con số nhưng sai mục tiêu: thước đo chọn sai thì agent càng chăm càng hỏng.
Cách bắt đầu của tôi: chọn một việc nhỏ, có bộ dữ liệu kiểm tra cố định, chạy trong máy riêng, đọc kỹ results.tsv vài lần đầu trước khi để agent chạy qua đêm.
Muốn agent làm việc suốt đêm, hãy khóa chặt cái thước đo trước khi đi ngủ.
Xem bài này trong chuỗi dòng thời gian AI.
Câu hỏi thường gặp
autoresearch có chạy được trên máy không có GPU NVIDIA không?
Bản gốc autoresearch thì không. README nói hiện chỉ hỗ trợ một GPU NVIDIA, người cần nền tảng khác có thể tham khảo nanochat hoặc các bản fork của cộng đồng.
autoresearch dùng agent nào?
README không gắn với agent cụ thể. Tác giả gợi ý mở Claude hoặc Codex, hay bất kỳ agent nào anh chị muốn, ngay trong thư mục repo rồi bảo agent đọc program.md.
Mỗi đêm autoresearch chạy được bao nhiêu thí nghiệm?
Theo README, mỗi lần huấn luyện cố định 5 phút nên mỗi giờ được 12 lần, một đêm ngủ chừng 100 lần. Số thật còn tùy thời gian agent đọc log và sửa code. Nguồn: karpathy/autoresearch trên GitHub, 07/03/2026.
Nguồn tham khảo: https://github.com/karpathy/autoresearch