gpt-oss là gì: mô hình mở trọng số của OpenAI, chạy tại máy
gpt-oss là gì: hai mô hình mở trọng số gpt-oss-120b và gpt-oss-20b của OpenAI, giấy phép Apache 2.0, chạy trên máy bằng Ollama, LM Studio, vLLM.
Thử hình dung buổi họp giao ban thứ Hai. Trưởng phòng nhân sự hỏi: "Dán quy chế lương vào ChatGPT cho nó tóm tắt có sao không?". Anh IT gãi đầu: "Dữ liệu sẽ đi ra máy chủ bên ngoài, chị ạ". Thế là cả phòng quay lại đọc tay 40 trang quy chế.
Từ ngày 05/08/2025, câu chuyện đó có thêm một lối ra. gpt-oss là dòng mô hình mở trọng số của OpenAI, gồm gpt-oss-120b và gpt-oss-20b, tải về chạy trên máy của mình được, dùng cho suy luận, làm agent và phát triển ứng dụng. OpenAI công bố hai mô hình cùng repo openai/gpt-oss trên GitHub, theo giấy phép Apache 2.0.
Đọc nhanh trong 30 giây
- gpt-oss là hai mô hình mở trọng số của OpenAI, công bố ngày 05/08/2025, giấy phép Apache 2.0, dùng thương mại được.
- Bản gpt-oss-20b chạy trong 16GB bộ nhớ; bản gpt-oss-120b vừa một GPU H100.
- Cách dễ nhất: cài Ollama rồi chạy
ollama run gpt-oss:20b. Cũng chạy được bằng LM Studio, vLLM, Transformers.- Hợp với đơn vị có dữ liệu nhạy cảm, muốn AI chạy hoàn toàn trong mạng nội bộ.
gpt-oss là gì, có gì khác ChatGPT?
gpt-oss là mô hình anh chị tự tải về và tự chạy, còn ChatGPT là dịch vụ chạy trên máy chủ của OpenAI. Khác nhau như nấu cơm nhà và ăn hàng: ăn hàng tiện, món ngon, nhưng bếp nằm ở chỗ người khác. Nấu ở nhà thì tốn công đi chợ, rửa nồi, đổi lại biết rõ từng thứ bỏ vào nồi và không ai thấy mâm cơm nhà mình.
Hai bản khác nhau thế này, theo README của OpenAI:
| gpt-oss-120b | gpt-oss-20b | |
|---|---|---|
| Tổng tham số | 117 tỷ | 21 tỷ |
| Tham số hoạt động | 5,1 tỷ | 3,6 tỷ |
| Phần cứng | Vừa một GPU H100 | Chạy trong 16GB bộ nhớ |
| Dùng cho | Sản xuất, việc cần suy luận cao | Độ trễ thấp, chạy tại máy, việc chuyên biệt |
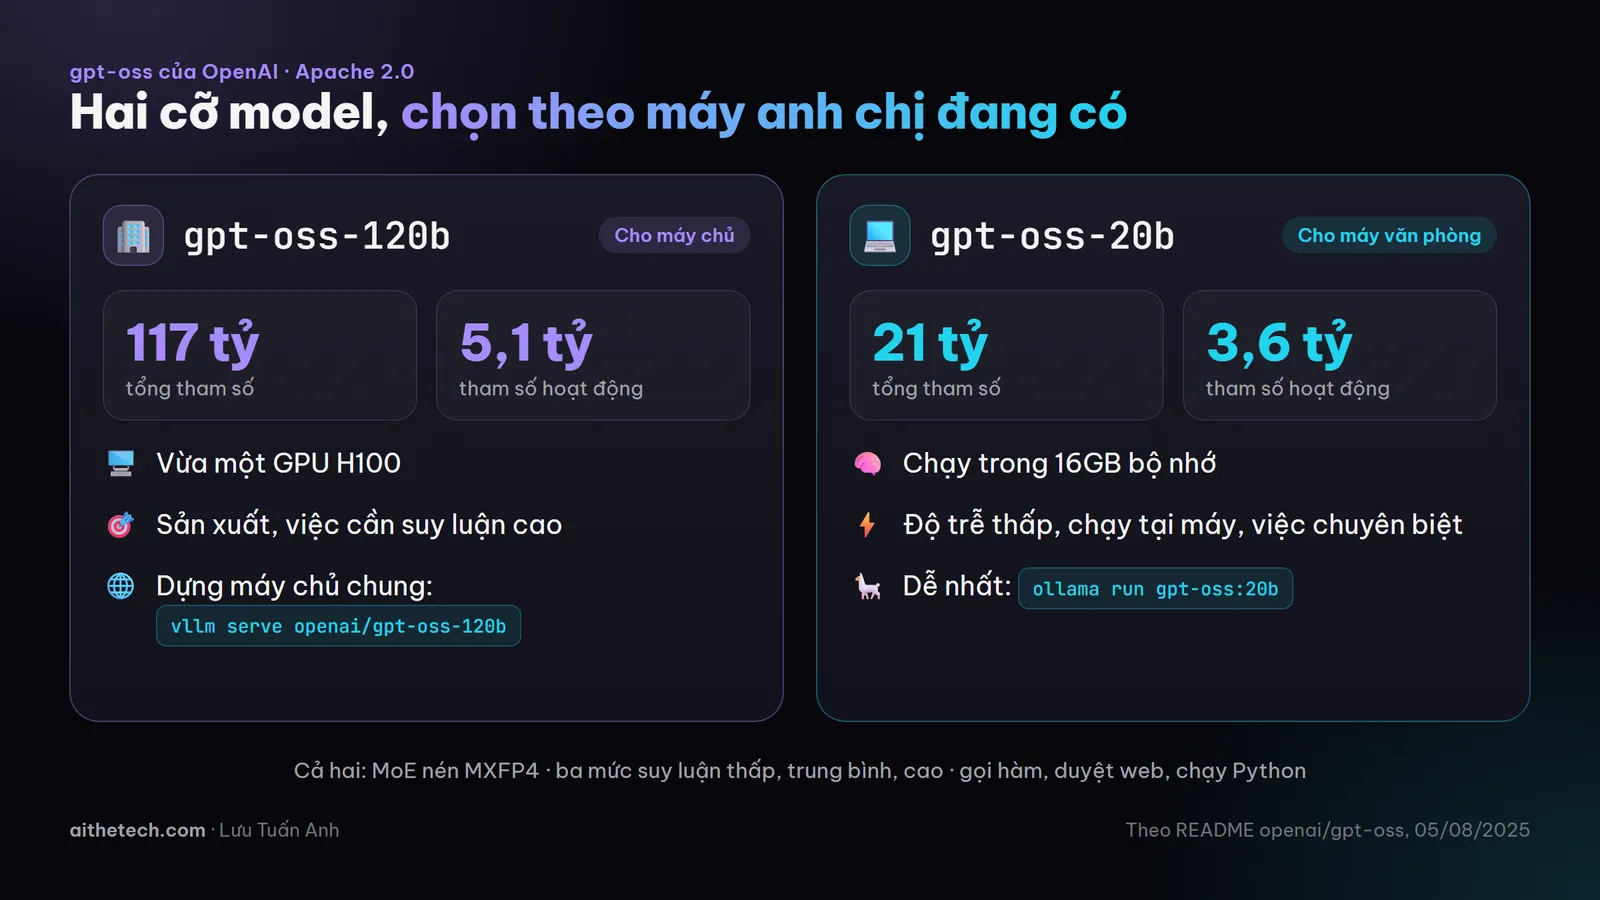
Hai cỡ, hai chỗ đứng: một bản cho máy chủ, một bản cho máy văn phòng.
Vì sao model lớn vậy mà chạy nhẹ?
gpt-oss chạy nhẹ nhờ hai mẹo: kiến trúc MoE và định dạng nén MXFP4. MoE giống một tổng đài lớn có rất nhiều nhân viên, nhưng mỗi cuộc gọi chỉ được chuyển tới vài người đúng chuyên môn. Vì thế 117 tỷ tham số mà mỗi lần xử lý chỉ dùng 5,1 tỷ.
MXFP4 là kiểu lưu số 4 bit, lớp MoE được huấn luyện sẵn ở định dạng này. Giống một cuốn từ điển dày được in khổ nhỏ mà vẫn đọc rõ chữ.
README nêu thêm các điểm đáng chú ý:
- Giấy phép Apache 2.0: không ràng buộc copyleft, không rủi ro bằng sáng chế, dùng thương mại được.
- Chỉnh mức suy luận: ba mức thấp, trung bình, cao. Theo thẻ mô hình trên Hugging Face, mức này đặt trong system prompt, ví dụ
Reasoning: high. - Xem toàn bộ chuỗi suy nghĩ: giúp dò lỗi, nhưng OpenAI ghi rõ phần này không dành để hiển thị cho người dùng cuối.
- Fine-tune được: chỉnh lại theo việc riêng.
- Khả năng agent: gọi hàm, duyệt web, chạy code Python, xuất dữ liệu có cấu trúc.
Lưu ý
Hai model được huấn luyện theo định dạng hội thoại harmony và chỉ nên dùng với định dạng này, nếu không sẽ chạy sai. Cứ như nộp hồ sơ phải điền đúng mẫu đơn của cơ quan. Tin vui: dùng chat template của Transformers, Ollama hay LM Studio thì định dạng được áp tự động. Tự gọi
model.generatethì dùng thư việnopenai-harmony.
Chạy gpt-oss trên máy: chọn một trong bốn đường
Cách dễ nhất: Ollama. README gợi ý Ollama cho máy tính thông thường. Cài Ollama xong, chạy:
# gpt-oss-20b
ollama pull gpt-oss:20b
ollama run gpt-oss:20b
Bản lớn thì thay 20b bằng 120b.
LM Studio, cho người thích giao diện:
lms get openai/gpt-oss-20b
vLLM, để dựng máy chủ có API tương thích OpenAI cho cả công ty dùng chung:
uv pip install --pre vllm==0.10.1+gptoss \
    --extra-index-url https://wheels.vllm.ai/gpt-oss/ \
    --extra-index-url https://download.pytorch.org/whl/nightly/cu128 \
    --index-strategy unsafe-best-match

vllm serve openai/gpt-oss-20b
Lệnh vllm serve tự tải model và mở máy chủ. Ứng dụng nội bộ đang gọi API OpenAI có thể trỏ sang máy chủ này.
Transformers: dùng pipeline("text-generation", model="openai/gpt-oss-120b", ...) như ví dụ trong README, chat template tự áp định dạng harmony.
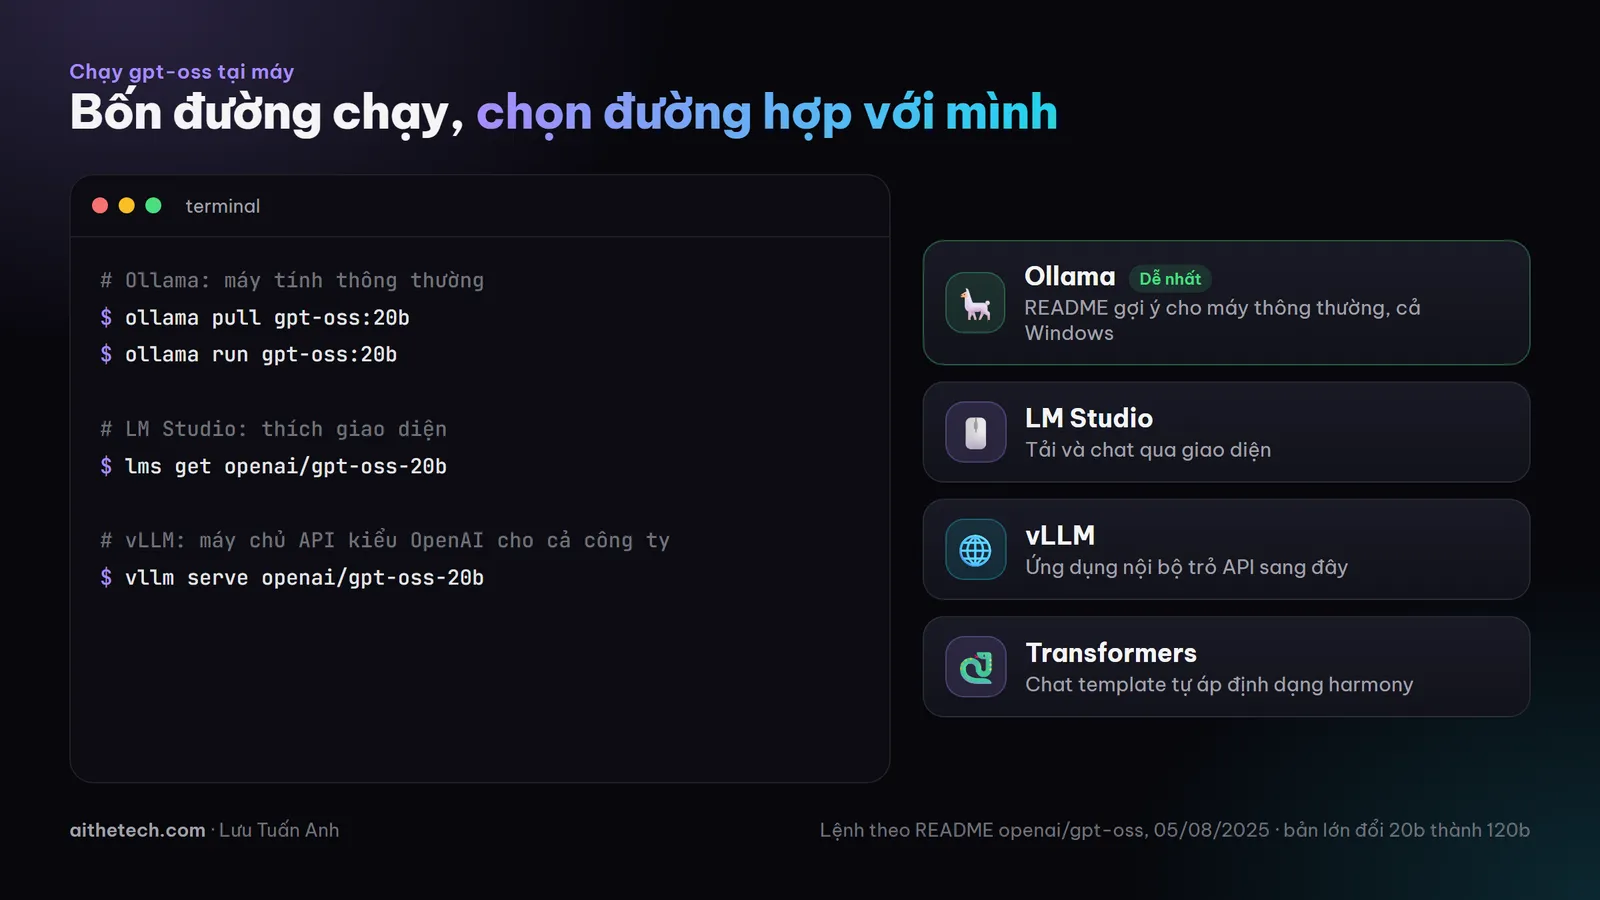
Bốn đường chạy gpt-oss, từ máy cá nhân tới máy chủ chung của công ty.
Repo còn có pip install gpt-oss cho bộ công cụ tham khảo và các bản cài PyTorch, Triton, Metal. OpenAI ghi rõ các bản tham khảo này phục vụ học tập, không dành cho sản xuất. Trên Windows, README cho biết các bản tham khảo chưa được kiểm thử và gợi ý dùng Ollama.
Mẹo
Bắt đầu bằng mức
Reasoning: medium. Câu hỏi tra cứu đơn giản thì hạ xuốnglowcho nhanh, việc phân tích nhiều bước mới nâng lênhigh.
Hai cách dùng thực tế trong văn phòng
Trợ lý đọc quy chế không ra Internet. Quay lại phòng nhân sự ở đầu bài. Cài Ollama trên một máy có đủ 16GB bộ nhớ, chạy gpt-oss:20b, dán nội dung quy chế vào và hỏi:
Reasoning: medium
Dựa vào quy chế dưới đây, nhân viên thử việc có được nghỉ phép năm không, mấy ngày?
Chỉ trả lời theo văn bản, ghi rõ điều khoản. Không có thì nói không có.
Máy chủ AI chung cho văn phòng. Bộ phận IT dựng vllm serve openai/gpt-oss-120b trên một máy có GPU H100, các công cụ nội bộ gọi qua API kiểu OpenAI. Dữ liệu nằm trong mạng công ty.
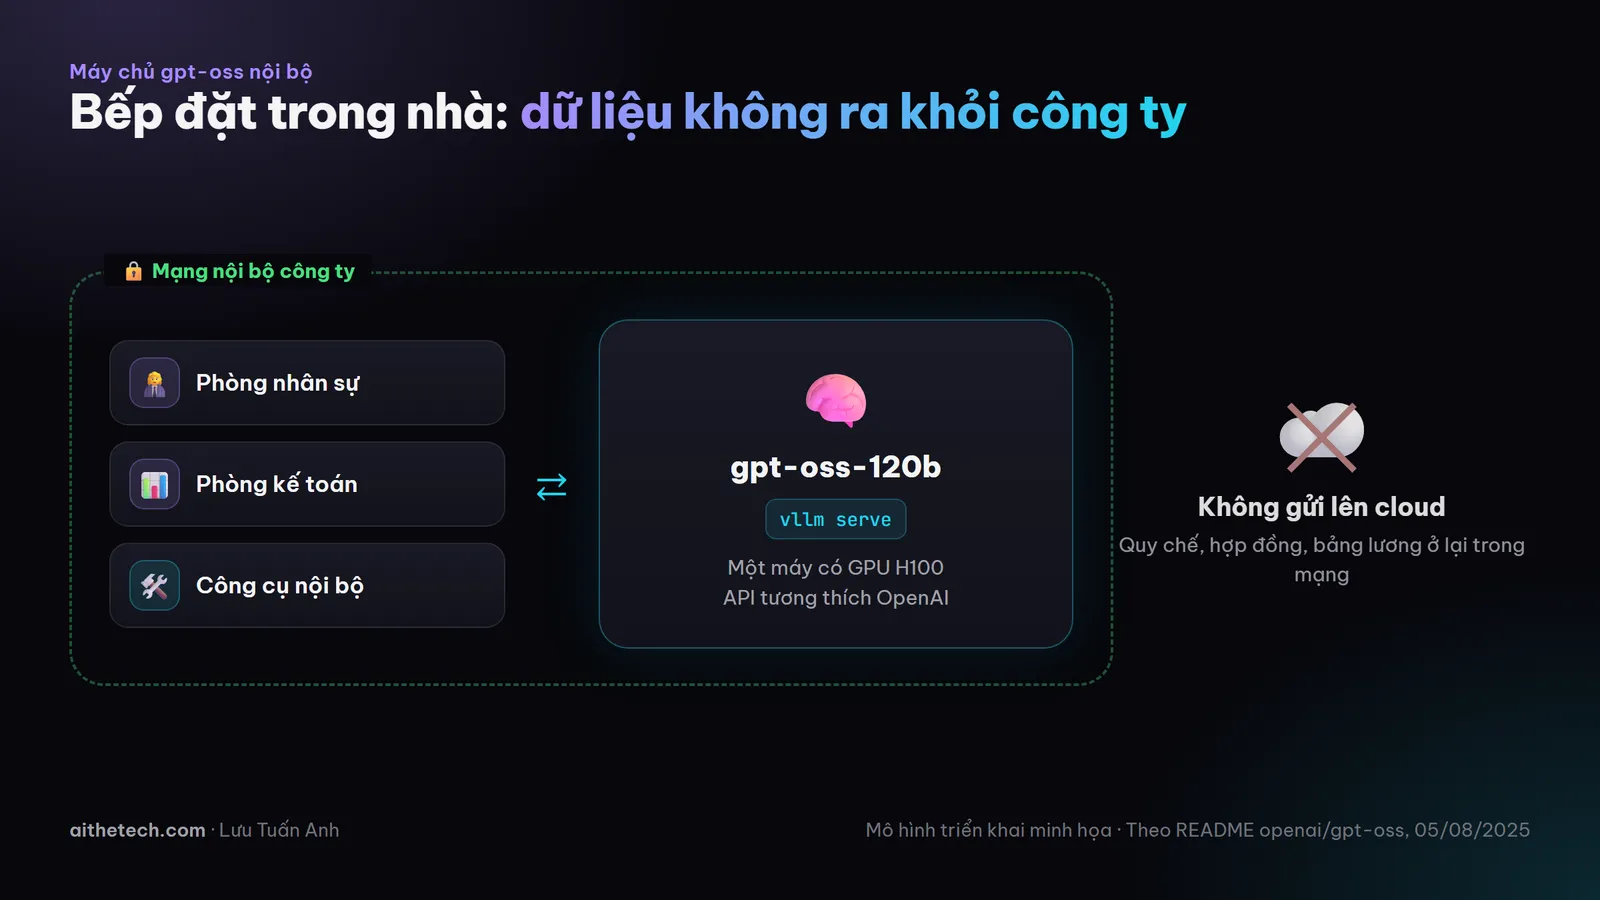
Bếp đặt trong nhà: mọi câu hỏi và tài liệu ở lại trong mạng công ty.
Nếu anh chị đang so sánh các model mở, bài Kimi K2 là gì và GLM-4.5 là gì là hai lựa chọn ra trước đó vài tuần, nhưng đều cần cụm nhiều GPU để tự chạy.
Những giới hạn cần biết trước
- Chính sách sử dụng: ngoài Apache 2.0 còn file chính sách yêu cầu người dùng tuân thủ pháp luật hiện hành.
- Chuỗi suy nghĩ không lọc: OpenAI khuyên không hiển thị cho người dùng cuối. Ứng dụng cho khách hàng cần ẩn đi.
- 16GB là bộ nhớ, không phải mọi máy 16GB đều chạy mượt: README không nêu tốc độ trên từng loại máy. Nên thử trên máy thật.
- Bản tham khảo PyTorch cần ít nhất 4 GPU H100 vì chưa tối ưu, chỉ để học cấu trúc model.
Nhận xét của chuyên gia
Với doanh nghiệp Việt, tôi chú ý nhất tới gpt-oss-20b: một model của OpenAI chạy được trên máy trạm trong văn phòng, giấy phép rõ ràng, cài bằng hai lệnh Ollama. Câu hỏi tôi gặp nhiều nhất khi tư vấn, "dữ liệu công ty có bị đưa lên mạng không", giờ có thêm một câu trả lời thực tế.
Hợp với ai: đơn vị có dữ liệu nhạy cảm như hồ sơ nhân sự, hợp đồng, tài chính; văn phòng muốn thử AI mà chưa muốn ký hợp đồng API; đội kỹ thuật cần model fine-tune được cho việc riêng.
Chưa hợp với ai: người cần chất lượng cao nhất cho việc khó và không ngại cloud, vì model mở cỡ nhỏ thường không thay được model lớn trên cloud cho mọi việc; công ty không có ai lo cập nhật, bảo trì máy chạy model. Chạy tại máy cũng không có nghĩa là an toàn tuyệt đối: vẫn cần phân quyền ai được hỏi gì và ghi lại câu hỏi.
Cách bắt đầu của tôi: cài Ollama trên một máy sẵn có, chạy gpt-oss:20b, cho một phòng ban thử hai tuần với một việc cụ thể như tóm tắt biên bản họp. Ghi lại những câu model trả lời sai để quyết định có cần bản 120b hay giữ cloud cho phần đó.
Một câu để nhớ: gpt-oss không phải ChatGPT miễn phí, mà là căn bếp AI anh chị được đặt ngay trong nhà mình.
Câu hỏi thường gặp
gpt-oss có miễn phí không?
Có. Trọng số gpt-oss-120b và gpt-oss-20b tải miễn phí trên Hugging Face, giấy phép Apache 2.0, dùng thương mại được. Chi phí chỉ là máy chạy và điện.
Máy tính nào chạy được gpt-oss-20b?
Theo README, gpt-oss-20b chạy trong 16GB bộ nhớ. gpt-oss-120b cần một GPU 80GB như H100. Cách dễ nhất trên máy thông thường là dùng Ollama.
gpt-oss có giống ChatGPT không?
Không hẳn. gpt-oss là model mở do OpenAI phát hành để anh chị tự chạy, còn ChatGPT là dịch vụ trên cloud của OpenAI. README không so sánh chất lượng giữa hai bên.
Chỉnh mức suy luận của gpt-oss thế nào?
Đặt mức thấp, trung bình hoặc cao trong system prompt, ví dụ Reasoning: high. Mức cao trả lời kỹ hơn nhưng chậm hơn.
Xem các mốc khác trong dòng thời gian AI 2025 tới 2026.
Nguồn tham khảo: https://github.com/openai/gpt-oss