Weight-Space Programming: AI tự sửa trọng số của một AI khác
MIT CSAIL cho GPT-6 Astra sửa thẳng 0,016% trọng số Qwen3.5-0.8B, điểm MATH-500 từ 7,9% lên 48,1% mà không cần huấn luyện. Giải thích dễ hiểu.
Thử hình dung một mô hình AI giống một khung não rỗng gồm hàng trăm triệu ô số. Lúc mới tạo, ô nào cũng gần như bằng 0. Huấn luyện là quá trình dò xem mỗi ô nên điền số mấy, để sau này đưa ảnh con chó vào thì nó nói "chó", đưa bài toán vào thì nó giải ra đáp án.
Ngày 02/11/2026, bốn nhà nghiên cứu ở MIT CSAIL công bố một cách làm khác: không huấn luyện thêm, mà giao cho một AI lớn đọc thẳng các ô số của AI nhỏ rồi tự tay sửa. Họ gọi việc này là Weight-Space Programming, tạm hiểu là "lập trình trực tiếp trên trọng số".
Đọc nhanh trong 30 giây
- Nhóm Rikiya Takehi, Jayden Teoh, Alex Zhang, Omar Khattab (MIT CSAIL) cho GPT-6 Astra sửa trọng số của Qwen3.5-0.8B mà không dùng gradient, không huấn luyện.
- Astra chỉ đổi 131.072 trọng số, tức 0,016%. Điểm MATH-500 tăng từ 7,9% lên 48,1%, GSM8K từ 13,8% lên 67,1%, IFEval từ 21,0% lên 62,3%.
- Thứ được sửa là lỗi lặp suy luận: mô hình hay nói vòng vo tới hết giới hạn token mà không ra đáp án.
- Đánh giá nhanh: kết quả rất đáng chú ý nhưng còn sớm, là bài blog chứ chưa phải bài báo bình duyệt, và chính tác giả nói cách này không thêm được khả năng mới cho mô hình.
Trọng số là gì, vì sao sửa trực tiếp lại khó?
Trọng số là các con số bên trong mô hình AI quyết định nó "nghĩ" ra sao. Qwen3.5-0.8B có 0,8 tỷ con số như vậy.
Với một bộ não ba ô, từ [0, 0, 0] thành [6, 7, 8], ta cứ thử từng ô là ra. Nhưng với hàng trăm triệu ô, việc dò tay giống chơi sudoku có hàng tỷ hàng và cột. Vì vậy người ta dùng toán, cụ thể là thuật toán gradient descent, để dò hàng loạt ô cùng lúc. Đó chính là huấn luyện, và cũng là lý do huấn luyện cần rất nhiều GPU và bộ nhớ chạy song song.
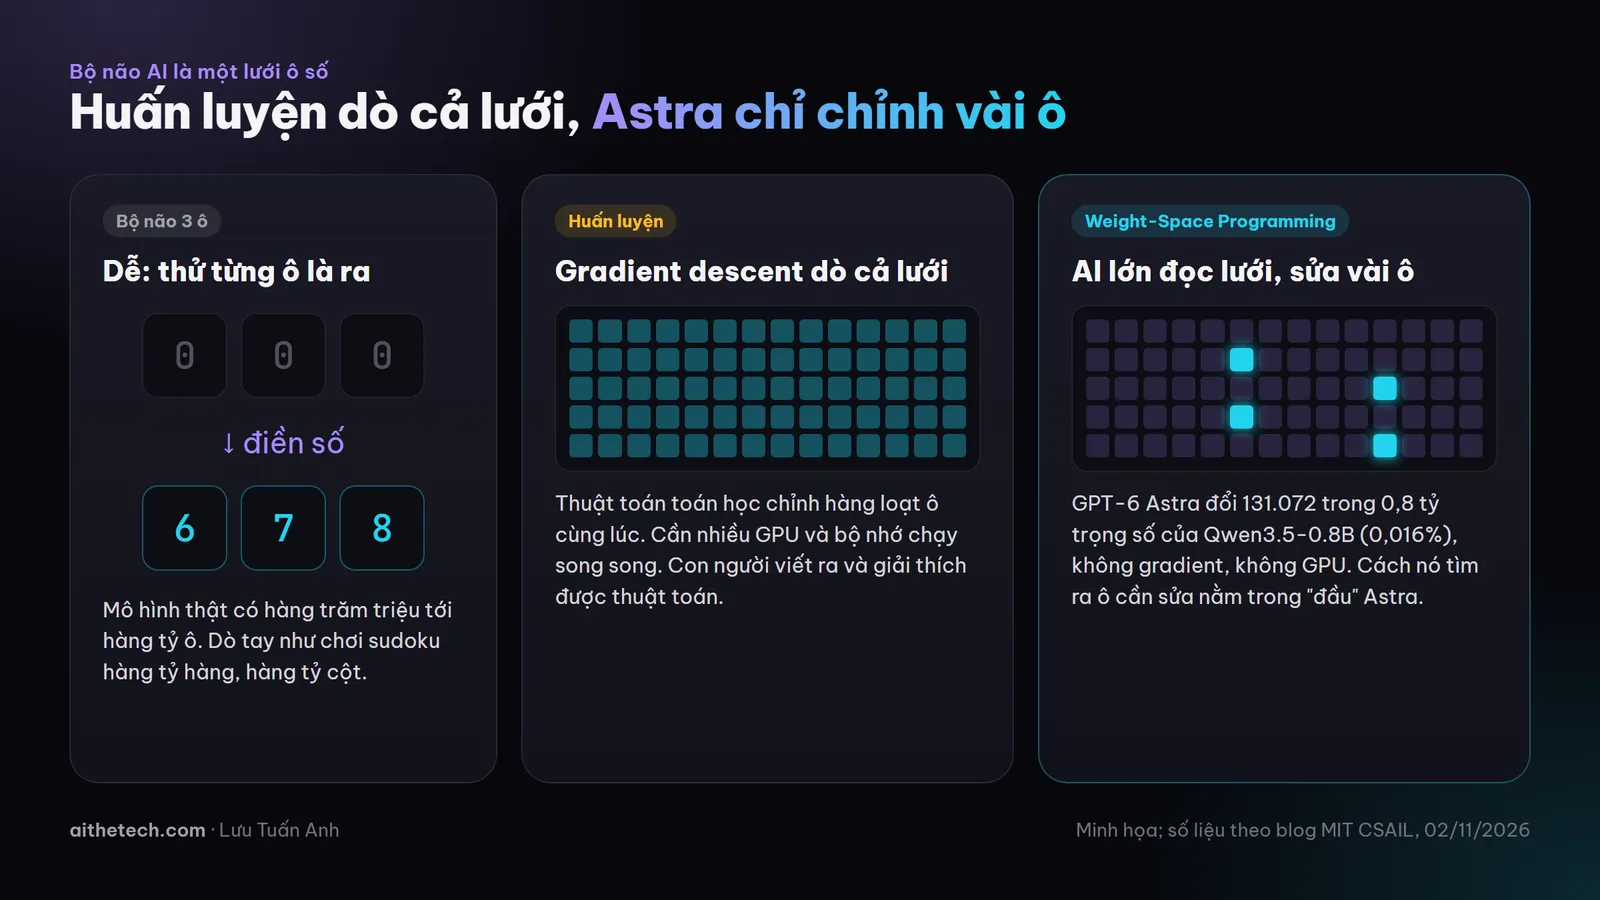
Huấn luyện dò cả lưới. Weight-Space Programming chọn vài ô để sửa.
Ý tưởng sửa thẳng trọng số không mới. Cái khó là biết sửa ô nào, thành số mấy, mà không làm hỏng chỗ khác. Giống sửa một chiếc đồng hồ cơ: thợ giỏi chỉ chỉnh đúng một bánh răng, thợ kém tháo ra thì hỏng thêm ba chỗ.
GPT-6 Astra đã sửa Qwen3.5-0.8B như thế nào?
GPT-6 Astra đọc trọng số của Qwen3.5-0.8B, tìm ra nguyên nhân lỗi lặp suy luận rồi trừ đi đúng phần gây lỗi. Theo blog của nhóm MIT:
- Astra lần ra vòng lặp bắt nguồn từ một hướng tín hiệu do khối MLP ở lớp 15 và lớp 19 ghi vào.
- Nó trừ hướng đó khỏi 64 cột đầu ra ở mỗi lớp. Tổng cộng 131.072 trọng số bị đổi.
- Astra làm việc trong một môi trường Python không có GPU, không gradient. Nó được chạy thử mô hình trên bài luyện tập từ tập huấn luyện GSM8K và MATH, với ngân sách 10, 25 hoặc 50 lần chạy, và xen kẽ chỉnh sửa giữa các lần chạy.
- Đề kiểm tra MATH-500, GSM8K và sáu bộ đánh giá khác thì Astra không được thấy.
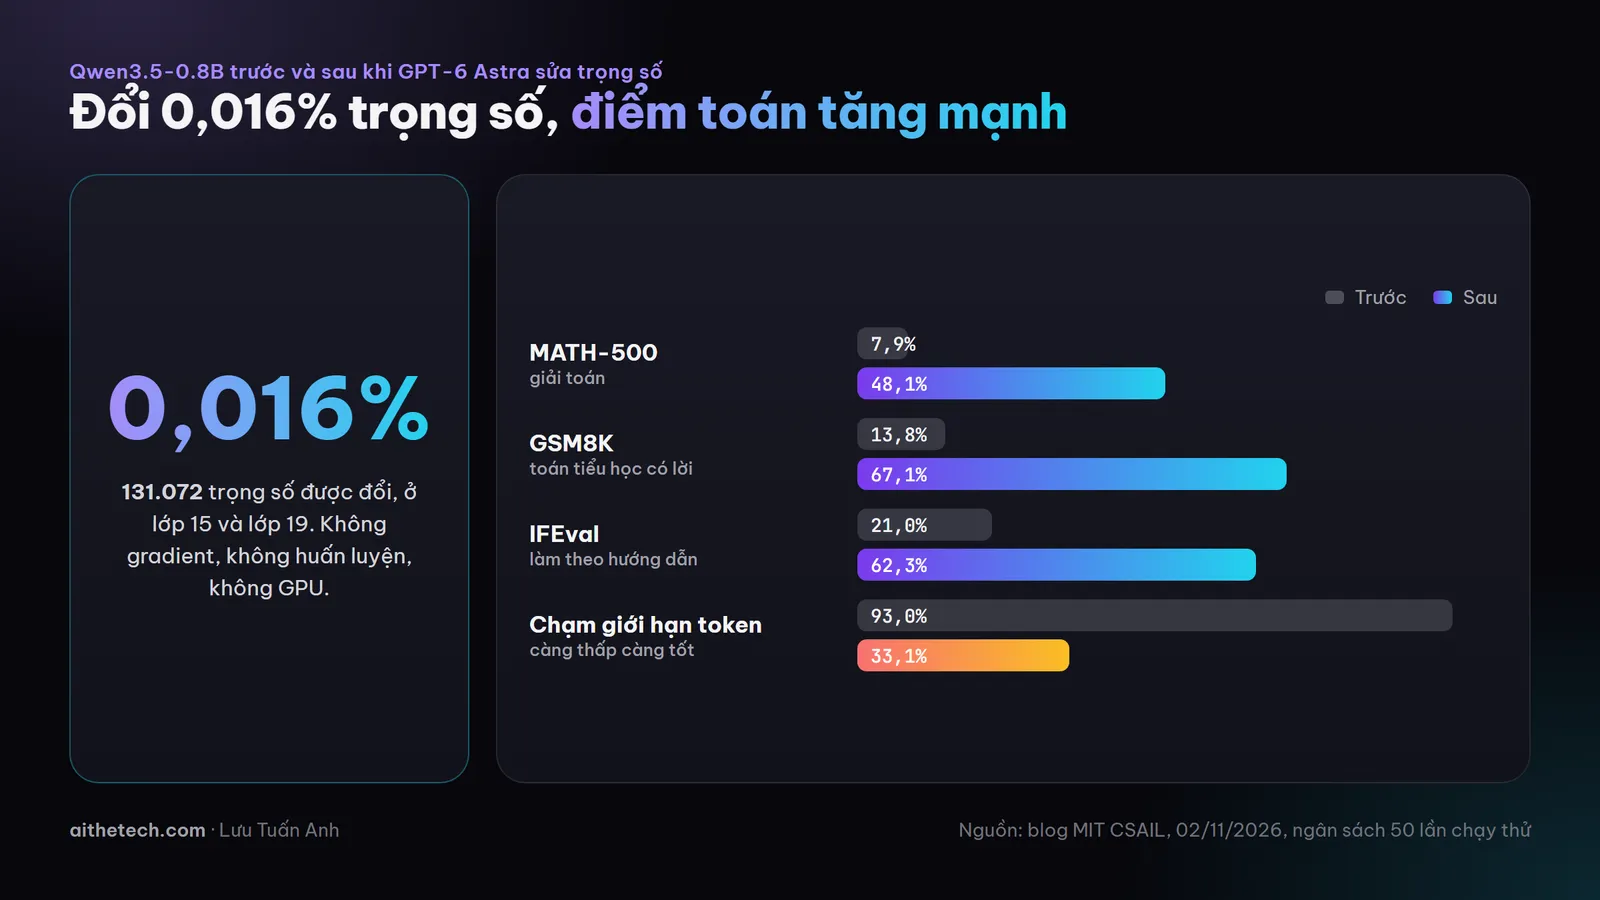
Số liệu theo blog MIT CSAIL, ngân sách 50 lần chạy thử.
| Chỉ số | Trước | Sau |
|---|---|---|
| MATH-500 | 7,9% | 48,1% |
| GSM8K | 13,8% | 67,1% |
| IFEval (làm theo hướng dẫn) | 21,0% | 62,3% |
| Câu trả lời chạm giới hạn token | 93,0% | 33,1% |
Chi tiết đáng chú ý: Astra chỉ được giao việc "làm mô hình giỏi toán hơn", nhưng điểm làm theo hướng dẫn cũng tăng, từ 21,0% lên 62,3%. Lý do là cùng một lỗi lặp đã kéo cả hai kỹ năng xuống.
Ngoài sửa lỗi, AI còn đọc và viết trọng số được tới đâu?
Bài blog có thêm vài thí nghiệm cho thấy Astra "đọc" được trọng số:
- Nhìn trọng số của bốn mạng chơi game có cùng kiến trúc, Astra đoán đúng cả bốn trò: Breakout, Pong, Pac-Man, Freeway.
- Với ba mô hình ngôn ngữ nhỏ, nó nói đúng ngôn ngữ huấn luyện của cả ba và tìm ra mọi copying head mà không chỉ nhầm cái nào.
- Viết từ con số 0, trong một lần thử, không chạy môi trường game, Astra tạo mạng chơi game vượt các mạng huấn luyện bằng PPO 100 triệu bước ở cả ba trò Breakout, Seaquest, Asterix. So với PPO 500 triệu bước thì Astra chỉ thắng ở Breakout.
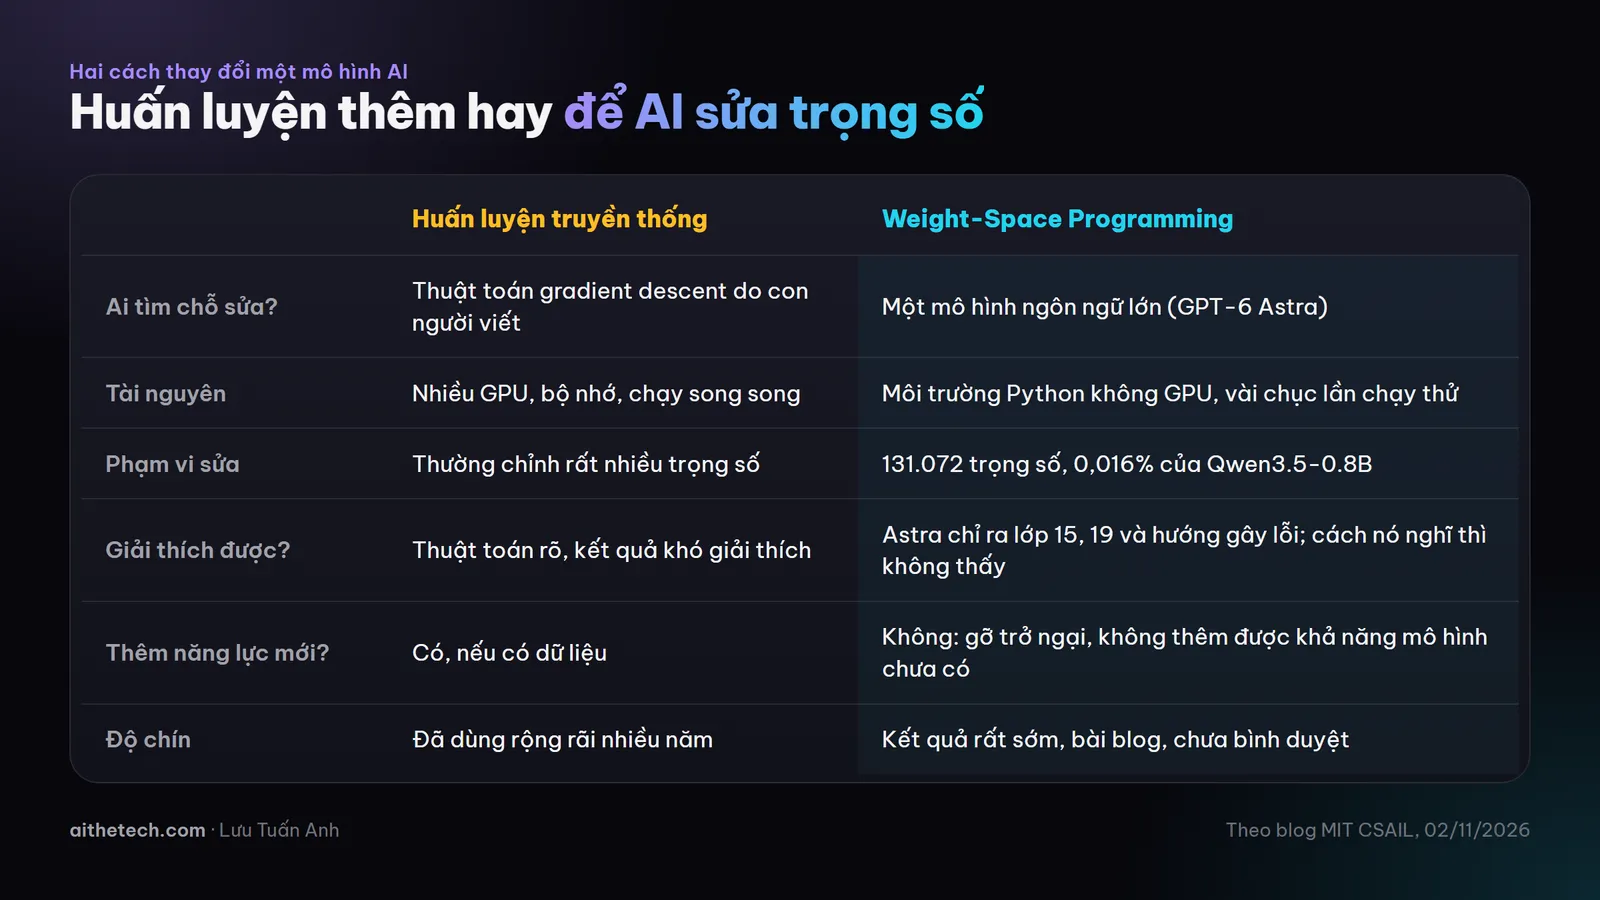
Hai cách thay đổi một mô hình, theo mô tả trong blog MIT CSAIL.
Mẹo
Đọc tin AI kiểu này, hãy tìm ba thứ trong bài gốc: mô hình nào bị sửa (to hay nhỏ), so với cái gì (trước sau, hay so với cách khác), và tác giả tự nói giới hạn gì. Ba thứ đó thường nằm cuối bài, ít khi lên tiêu đề.
Góc nhìn phản biện: đừng đọc thành "AI tự làm mình thông minh hơn"
Cảnh báo
- Gỡ chướng ngại, không thêm năng lực. Với Gemma 3 270M, Astra không cải thiện được toán (6,8% lên tối đa 7,7%). Tác giả viết rằng sửa trọng số gỡ được trở ngại che khuất một khả năng, nhưng không thêm được khả năng mô hình chưa có. Qwen tăng điểm vì vốn đã biết làm toán, chỉ bị vòng lặp chặn lại.
- Kết quả còn rất sớm. Đây là bài blog với kết quả ban đầu, chưa phải bài báo qua bình duyệt. Mô hình ngôn ngữ lớn nhất được thử chỉ 0,8B, và chỉ một AI làm thợ sửa là GPT-6 Astra.
- Có việc Astra làm hỏng. Chỉ nhìn trọng số, Astra thất bại cả bốn lần khi phải tìm mô hình nào có thói nịnh người dùng (sycophancy). Có thêm công cụ xem attention thì mới làm được.
- Lỗi chưa hết hẳn. Sau khi sửa, vẫn còn 33,1% câu trả lời MATH-500 chạm giới hạn token. Với ngân sách 10 hoặc 25 lần chạy thử, vòng lặp gần như không giảm.
Có một điểm phản biện thú vị hơn, nằm ở chính ý tưởng. Trước đây, muốn mô hình tốt lên thì con người cầm thuật toán: gradient descent viết ra được, giải thích được. Giờ thì "thuật toán tìm ô cần sửa" nằm trong đầu GPT-6 Astra, và chúng ta không moi nó ra được. Ta biết kết quả, không biết cách nghĩ. Giới nghiên cứu AI đang dùng một hộp đen để mổ xẻ một hộp đen khác.
Công bằng mà nói, lần này Astra có để lại dấu vết giải thích được: nó chỉ ra đúng lớp 15, lớp 19 và một hướng tín hiệu cụ thể. Con người kiểm lại được lời giải đó. Giống bác sĩ trẻ dùng máy chẩn đoán: máy chỉ ra chỗ bệnh, nhưng bác sĩ vẫn phải tự xem phim để tin máy.
Nhận xét của chuyên gia
Doanh nghiệp chưa dùng được kỹ thuật này vào ngày mai. Nhưng nó gợi ra hai điều đáng theo dõi. Một là chi phí cải tiến mô hình nhỏ có thể giảm mạnh: theo bài blog, Astra làm việc không cần GPU, trong khi huấn luyện lại thì cần cả cụm máy. Hai là bài toán kiểm soát: khi AI tự sửa AI, ai kiểm tra bản sửa có an toàn, có làm hỏng chỗ khác hay không.
Hợp với ai: đội kỹ thuật đang chạy mô hình mã nguồn mở nhỏ tại chỗ, người làm nghiên cứu về giải thích mô hình (interpretability), người cần hiểu xu hướng AI để tư vấn chiến lược.
Chưa hợp với ai: doanh nghiệp chỉ dùng ChatGPT, Claude, Gemini qua giao diện có sẵn. Anh chị không chạm được vào trọng số của các mô hình này.
Cách bắt đầu của tôi: đọc thẳng bài gốc, đặc biệt mục giới hạn ở cuối. Nếu đội anh chị đang dùng mô hình mở như Qwen, hãy theo dõi benchmark và công cụ mà nhóm tác giả nói đang xây, trước khi nghĩ tới chuyện thử.
Một câu để nhớ: AI sửa được não AI, nhưng nó chỉ dọn đường cho điều mô hình vốn đã biết.
Câu hỏi thường gặp
Weight-Space Programming là gì?
Weight-Space Programming là cách để một mô hình ngôn ngữ lớn đọc và viết trực tiếp trọng số của một mạng nơ-ron theo mục tiêu viết bằng ngôn ngữ thường, không dùng gradient hay huấn luyện. Thuật ngữ do nhóm MIT CSAIL đặt trong bài blog ngày 02/11/2026.
Sửa 0,016% trọng số có làm mô hình thông minh hơn không?
Không hẳn. Trong thí nghiệm với Qwen3.5-0.8B, bản sửa gỡ lỗi lặp suy luận nên điểm toán tăng mạnh. Với Gemma 3 270M, điểm gần như không đổi, vì sửa trọng số không thêm được khả năng mà mô hình chưa có.
Kỹ thuật này có thay thế được huấn luyện mô hình không?
Chưa. Các thí nghiệm mới dừng ở mạng nhỏ, mô hình ngôn ngữ lớn nhất là 0,8B, và chỉ dùng một AI làm thợ sửa. Tác giả gọi đây là kết quả rất sớm.
Doanh nghiệp dùng ChatGPT hằng ngày có cần quan tâm không?
Chưa cần thay đổi gì. Tin này đáng biết để hiểu hướng đi của AI: cải tiến mô hình có thể rẻ hơn, và câu hỏi ai kiểm soát bản sửa sẽ ngày càng quan trọng.
Nguồn: Sparks of Weight-Space Programming, MIT CSAIL, 02/11/2026. Ngày tra nguồn: 05/11/2026.
Nguồn tham khảo: https://rikiyat.github.io/blog/weight-space-programming/